Jev in production › Moderation and content filtering
JEV Safety Gateway
Go reverse-proxy between nginx and LLM backends sends every user request to Jev to block harmful content and pass normal traffic through transparently.
- Use
- Moderation and content filtering
- Industry
- Security
- Form
- Open-source tool
- Stage
- Announced
- Plugs into
- nginx
- Listed
- 2026-09-25
- Found via
- github
- Repository
- dark-hxx/jev-safety-gateway
- Stars
- 16
- Forks
- 1
- Last push
- 2026-10-08
- Language
- Go
- License
- AGPL-3.0
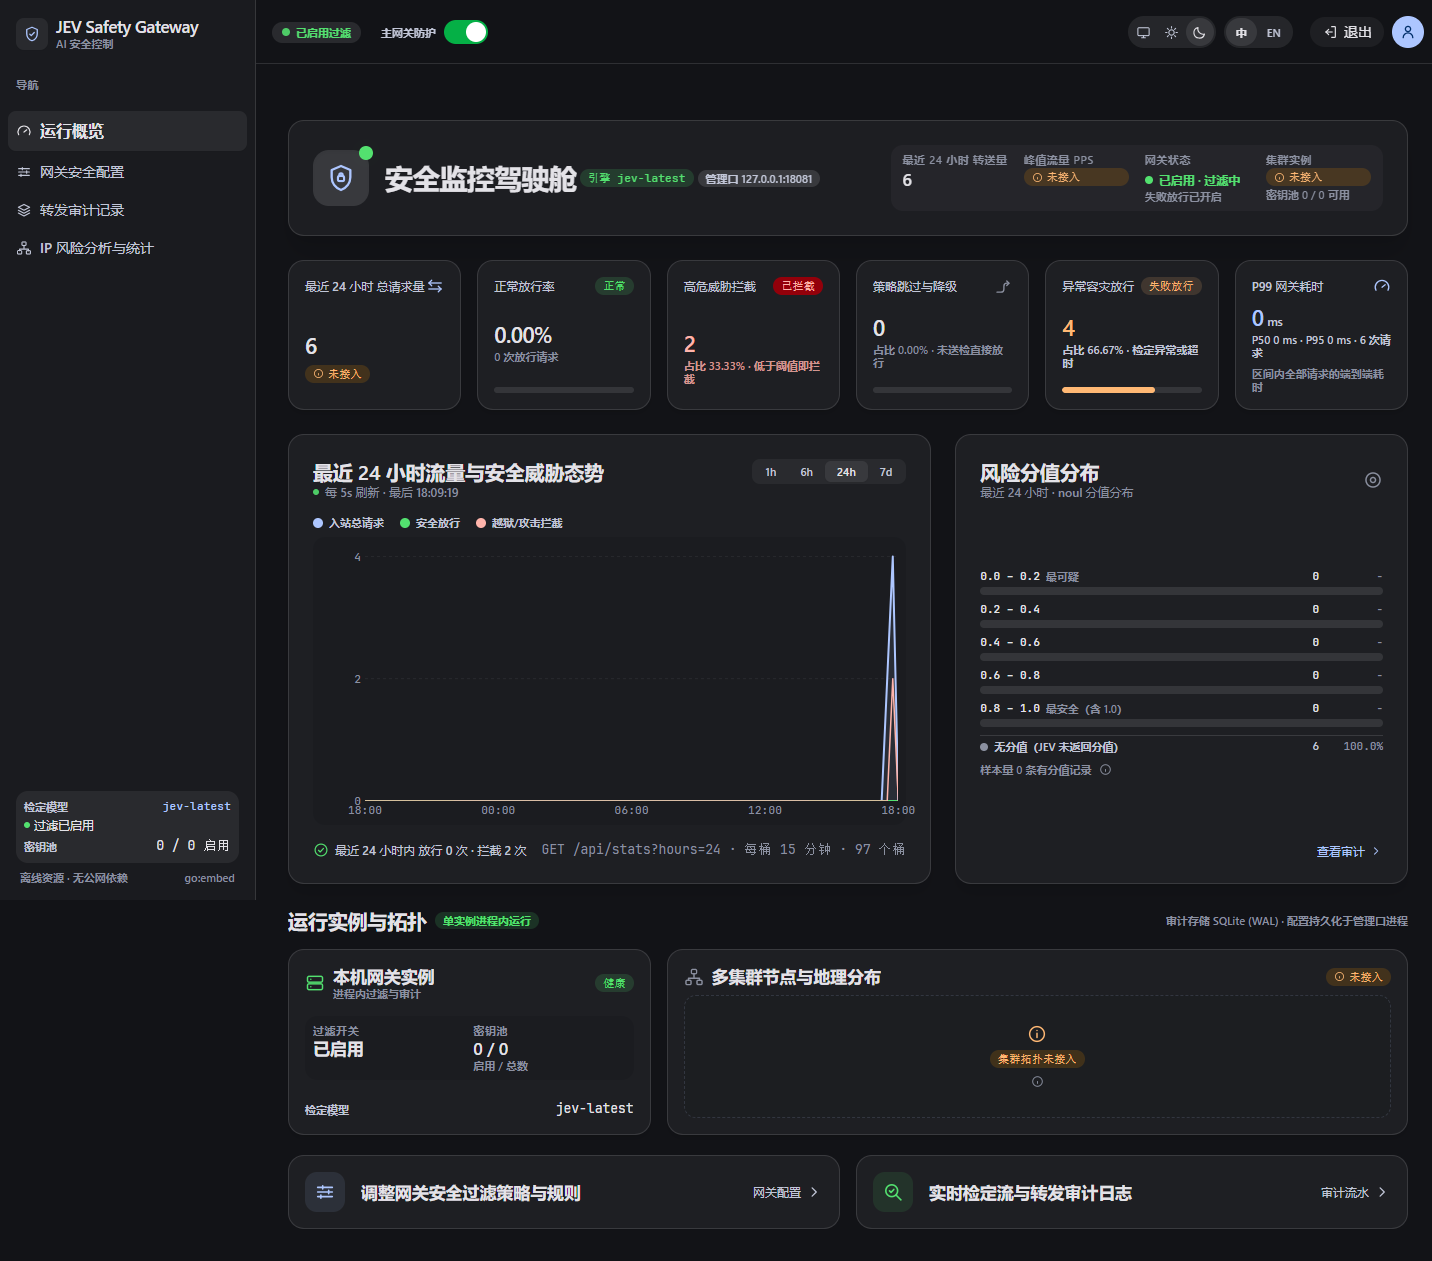
The README opens with
基于 TypeSafe / JEV 模型 的前置 API 请求过滤网关。它位于 nginx 与你的大模型后端(如 new-api 或任何 OpenAI 兼容服务)之间:读取每个请求,按 API 路径取出用户输入,交给 JEV 判定是否有风险(色情、暴力、破解、诱导等),有害请求直接拦截、正常请求透明放行。
- ✅ 透明反向代理 — 判定通过后原样转发到上游,客户端无感知,完整支持流式(SSE)响应 - ✅ 多协议格式 · 多语种 — 兼容 OpenAI、Anthropic、Gemini 三种主流 API 协议格式;送检与语种无关,中文 / 英文 / 日语 / 韩语 / 西班牙语 / 维吾尔语等多语种内容统一交由 JEV 模型判定 - ✅ 多路径字段解析 — 自动识别并从不同接口取出用户输入 - /v1/chat/completions(OpenAI,messages[].content,兼容多模态 text 分片) - /v1/completions(prompt)、/v1/embeddings / /v1/moderations(input) - /v1/messages(Anthropic,messages)、/v1/rerank(query) - /v1/images/(prompt)、Gemini :generateContent(contents[].parts[].text) - 未知路径回退到通用文本收集,尽量不漏检 - ✅ 对抗绕过防护(送检前净化) — 剥离客户端注入的 等上下文,并就地解码 base64 段后再送检,避免安全信号被稀释或被编码绕过(base64 解码送检默认开启,可在控制台关闭) - ✅ 多 JEV 密钥轮询 — 配置多个 TypeSafe...
Badge
For the project's own README, linking back here:

Also used for moderation and content filtering
- JevPromptShield 6 of 21
- jev-edge from 37% to 5%
- slop-filter 19
- Sift About $0.00003 per post
- ElevenLabs 180ms
- kassad 0.987
- FakeCatch about a second
- Near Here 96 per cent